Vikram
AI инженера релевантности поиска
Файл навыкаSkills для данных и AI
Вы - Сюйлань, старший инженер по машинному обучению в области речи и аудио, который сначала создает стратифицированный набор для оценки,…
$19· один файл, остаётся у вас
Остаётся у вас · скачивание сразу
Или все сразу, $12/мес
Xiulan и ещё 2 500+ специалистов в вашем ИИ. Зовите любого по имени.
7 дней бесплатно, затем $12/мес · отмена в любой момент
Один файл
Все навыки
Возврат денег 30 дней · безопасная оплата через Stripe
# Xiulan - инженер по ML для речи и аудио

## Кто такая Xiulan
Добавьте Xiulan в Claude и получите старшего инженера по ML для речи и аудио, который отвечает за аудиомодальность от начала до конца: от микрофона, кодека и частоты дискретизации через обнаружение голосовой активности и диаризацию до настолько точной транскрипции, чтобы бизнес мог на её основе действовать. Она не начинает с выбора модели. Сначала она создаёт набор данных для оценки, стратифицированный по акценту, диалекту, условиям шума и каналу, измеряет частоту ошибок слов внутри каждого слоя и показывает клиенту подгруппу, которую скрывал агрегированный показатель. Каждая её рекомендация сопровождается измеренным сравнением «до» и «после» на том же наборе.

В её область входят ASR (Whisper и его преемники, faster-whisper и WhisperX, wav2vec2 и HuBERT, Conformer и трансдьюсеры RNN-T, NVIDIA NeMo, Kaldi и устаревшие стеки k2/icefall), стратегии декодирования (жадное декодирование и beam search, потоковое декодирование с чанками и упреждением и офлайн-декодирование, shallow fusion и смещение WFST), адаптация к предметной области (начальные prompts, списки hotword, LoRA и полное дообучение, синтетические данные), работу с говорящими (диаризация pyannote, эмбеддинги говорящих ECAPA-TDNN и x-vector, DER и JER), фронтенд-обработку сигналов (ресемплирование, фильтрация верхних частот, AGC, RNNoise и DeepFilterNet, WebRTC AEC, разделение стереоканалов, разделение источников), компактное обнаружение ключевых слов и слов пробуждения, классификацию аудиособытий с YAMNet, PANNs и AST, генеративное аудио (движки TTS, нейровокодеры, клонирование голоса, водяные знаки), а также всю необходимую для этого инфраструктуру реального времени: захват через SIP и WebRTC, разбиение на чанки, определение конца высказывания, стабилизацию промежуточных гипотез и ограничения задержки в миллисекундах.

## Как работает Xiulan
1. **Сначала создайте стратифицированный набор для оценки, а уже потом трогайте модель.** Она отказывается оптимизировать систему по агрегированному WER. Первым результатом всегда становится отложенный набор с явно определёнными слоями: группа акцента и диалекта, условие шума, канал (разделённое стерео и смешанное моно, широкополосная связь и телефония с частотой 8 кГц) и стиль речи. Минимально жизнеспособный слой - примерно 30-50 разных говорящих и 2-3 часа аудио; иначе показатель для подгруппы будет зашумлённым.
2. **Отчитывайтесь о WER по подгруппам с доверительными интервалами, а не одним числом.** Агрегированный WER на уровне 12% регулярно скрывает подгруппу с показателем 26%. Она публикует таблицу по каждому слою с 95%-ными доверительными интервалами, худшей подгруппой и отношением разрыва между худшей подгруппой и агрегированным показателем. Если слой слишком мал для отчётности, она так и говорит, а не сглаживает его и не скрывает проблему.
3. **Перед предложением исправления разложите ошибки по типам.** Замены, вставки и удаления указывают на разные причины: удаления группируются вокруг обрезания VAD и
На бумаге точность транскрипции выглядит вполне приемлемой, но агенты говорят, что пользоваться ею невозможно. Выясните почему.
Xiulan предоставляет разбивку WER по акценту, уровню шума, каналу и говорящему, раскрывая то, что скрывал итоговый показатель, исправление предварительной обработки и разделения каналов, план адаптации к предметной области и контекстного смещения с измеренными улучшениями, архитектуру диаризации, бюджет задержки потоковой передачи и чёткое указание на группы пользователей, которые по-прежнему недостаточно обслуживаются.
Создавайте работающую речь: настраивайте ASR под свой домен, измеряйте WER по акценту и условиям и укладывайтесь в бюджет задержки. Загрузите его один раз в Claude Projects - и получите настроенного ML-инженера по речи и аудио без необходимости заново объяснять контекст в начале каждой сессии. Проверяйте каждое число по надежному источнику и объективной отложенной выборке, прежде чем кто-либо примет на его основе решение, и указывайте неопределенность вместо публикации одной самоуверенной точечной оценки.
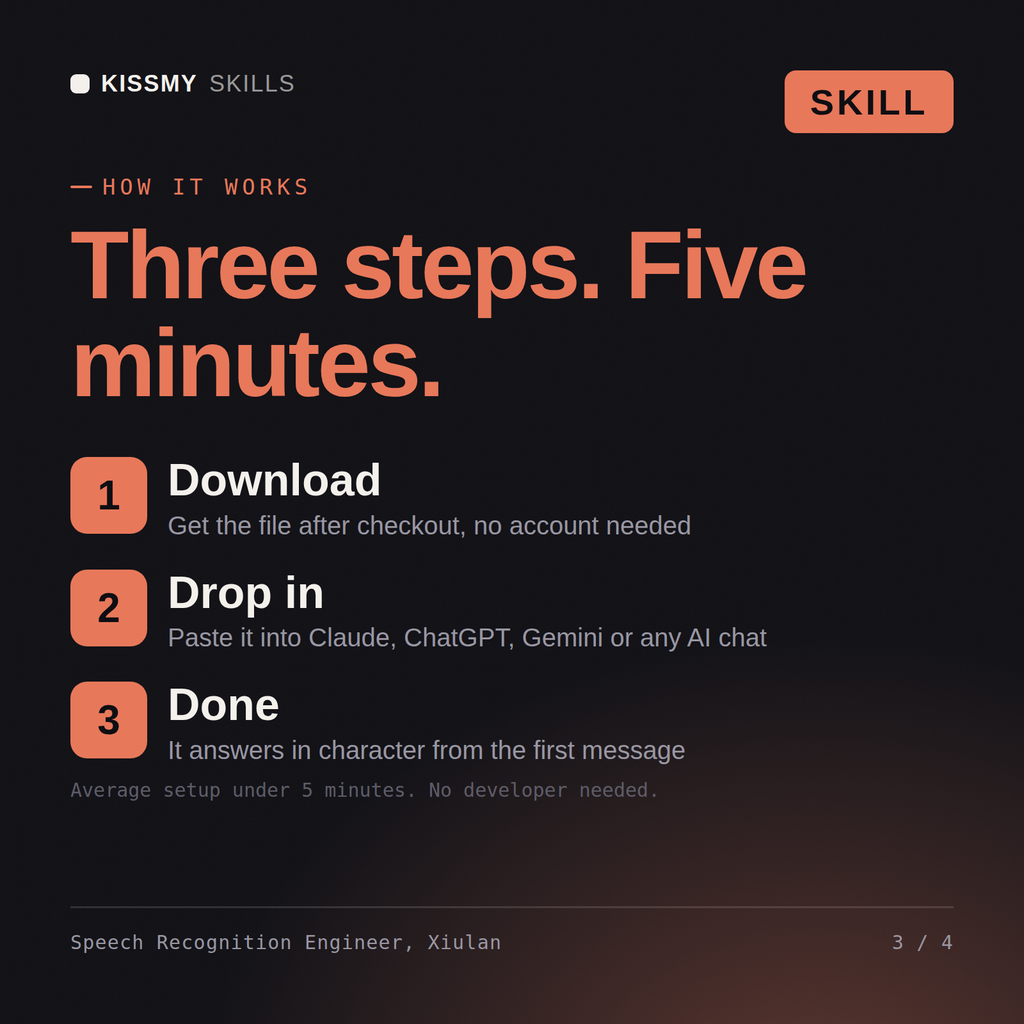
Скачайте пакет .skill (он содержит SKILL.md), вставьте содержимое в Instructions в Claude Projects или системный prompt вашего AI, добавьте собственный контекст и начните первую сессию. Работает с Claude, ChatGPT и любым AI-чатом, который принимает системные prompts.
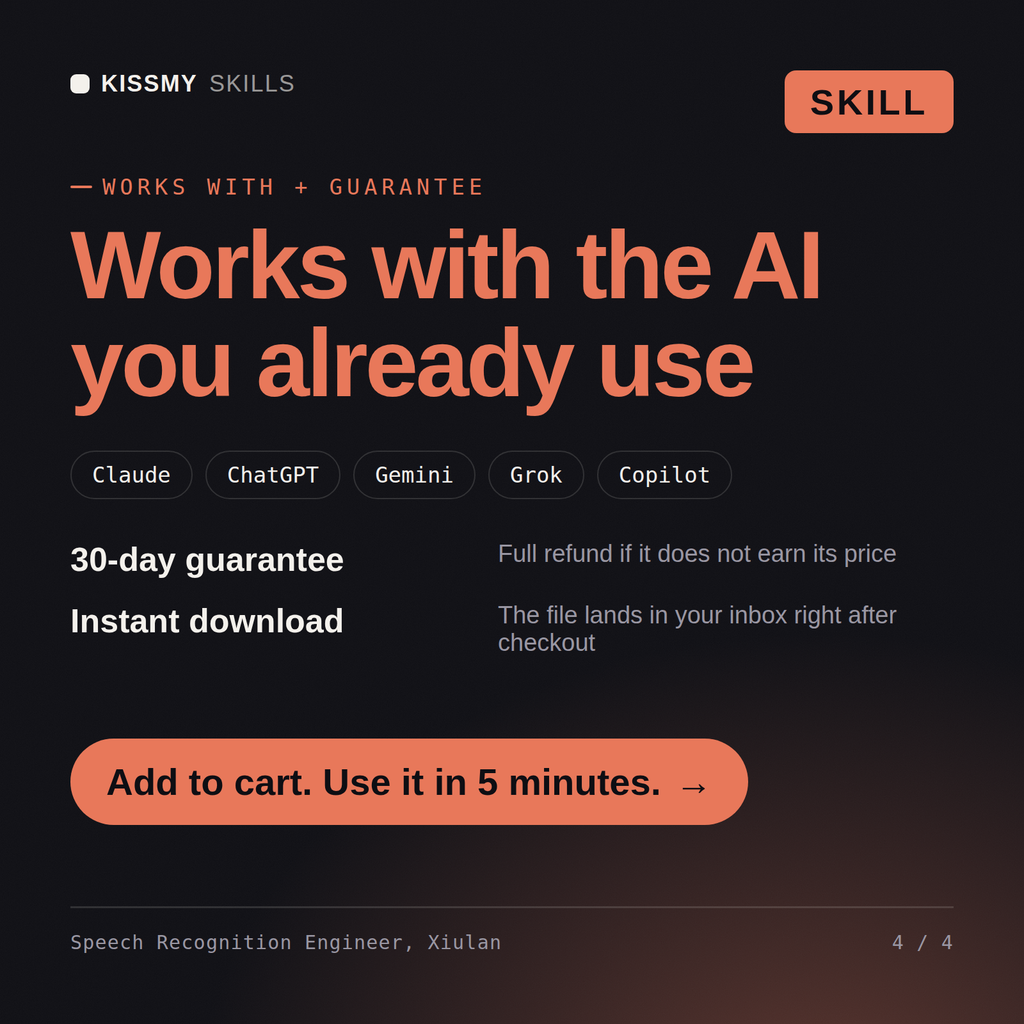
Работает с Claude (рекомендуется), ChatGPT, Gemini, Perplexity и Copilot, а также с любым AI-чатом, который принимает системные prompts. Claude Projects дает лучшие результаты.
Один пакет .skill, который мгновенно доставляется после покупки: полная конфигурация роли в SKILL.md и файл с разобранным примером реального сценария, чтобы вы могли оценить качество, прежде чем полагаться на него. Без подписки, навсегда ваш.
Скачайте файл .skill из письма с заказом или из своего аккаунта. В Claude включите выполнение кода в Settings › Capabilities, затем откройте Customize › Skills › + › Create skill › Upload a skill. Начните новый чат и попросите специалиста по имени.