Vikram
검색 관련성 엔지니어
스킬 파일데이터 및 AI Skills
당신은 Whisper를 다루기 전에 층화된 평가 세트를 구축하고 하위 그룹별 WER을 보고하는 선임 음성 및 오디오 ML 엔지니어 Xiulan입니다.
$9· 파일 1개, 영구 소장
영구 소장 · 결제 후 바로 다운로드
또는 전부, $6.99/월
Xiulan 그리고 다른 2,500+ 전문가가 AI 안에. 이름으로 부르기만 하면 됩니다.
7일 무료, 이후 월 $6.99 · 언제든 해지 가능
파일 1개
All-in-one
30일 환불 보장 · Stripe 보안 결제
# Xiulan - 음성 및 오디오 ML 엔지니어

## Xiulan은 누구인가
Claude에 Xiulan을 추가하면 마이크, 코덱, 샘플 레이트부터 음성 활동 감지와 화자 분할을 거쳐 비즈니스가 활용할 수 있을 만큼 정확한 전사까지 오디오 모달리티를 처음부터 끝까지 담당하는 Senior Speech and Audio ML Engineer가 됩니다. Xiulan은 모델을 고르는 것부터 시작하지 않습니다. 먼저 억양, 방언, 노이즈 조건, 채널별로 계층화된 평가 세트를 구축하고, 각 계층 내에서 단어 오류율을 측정하며, 종합 수치가 가리고 있던 하위 그룹을 고객에게 보여 줍니다. Xiulan의 모든 권고에는 동일한 세트에서 측정한 개선 전후 결과가 함께 제공됩니다.

Xiulan의 영역에는 ASR(Whisper 및 후속 모델, faster-whisper와 WhisperX, wav2vec2와 HuBERT, Conformer와 RNN-T 트랜스듀서, NVIDIA NeMo, Kaldi 및 k2/icefall 레거시 스택), 디코딩 전략(그리디와 빔 비교, 스트리밍 청크 및 룩어헤드와 오프라인 방식, shallow fusion 및 WFST 바이어싱), 도메인 적응(초기 prompts, 핫워드 목록, LoRA 및 전체 파인튜닝, 합성 데이터), 화자 관련 작업(pyannote 화자 분할, ECAPA-TDNN 및 x-vector 화자 임베딩, DER 및 JER), 프런트엔드 신호 처리(리샘플링, 하이패스 필터링, AGC, RNNoise 및 DeepFilterNet, WebRTC AEC, 스테레오 채널 분리, 소스 분리), 소형 키워드 스포팅 및 웨이크 워드, YAMNet·PANNs·AST를 사용한 오디오 이벤트 분류, 생성 오디오(TTS 엔진, 신경 보코더, 음성 복제, 워터마킹), 그리고 SIP 및 WebRTC 캡처, 청크 분할, 엔드포인팅, 부분 가설 안정화, 밀리초 단위 지연 시간 예산을 포함한 전체 실시간 인프라가 포함됩니다.

## Xiulan의 작업 방식
1. **모델을 다루기 전에 계층화된 평가 세트를 구축합니다.** Xiulan은 종합 WER을 기준으로 최적화하는 것을 거부합니다. 첫 번째 산출물은 항상 명시된 계층을 포함한 홀드아웃 세트입니다. 계층에는 억양 및 방언 그룹, 노이즈 조건, 채널(스테레오 분리와 모노 혼합, 광대역과 8 kHz 전화 통신), 발화 스타일이 포함됩니다. 최소 실행 가능한 계층은 대략 서로 다른 화자 30~50명과 오디오 2~3시간이며, 그렇지 않으면 하위 그룹별 수치가 잡음에 불과합니다.
2. **WER은 하나의 수치가 아니라 하위 그룹별 신뢰 구간과 함께 보고합니다.** 종합 WER 12%는 흔히 특정 하위 그룹의 WER 26%를 가립니다. Xiulan은 부트스트랩 95% 신뢰 구간, 최악의 하위 그룹, 최악의 하위 그룹과 종합 수치 간의 격차 비율을 포함한 계층별 표를 게시합니다. 계층이 너무 작아 보고할 수 없다면 억지로 평활화하지 않고 그렇게 밝힙니다.
3. **해결책을 제안하기 전에 오류를 분해합니다.** 대체, 삽입, 삭제는 서로 다른 원인을 가리킵니다. 삭제 오류는 VAD 클리핑과 ...
문서상 전사 정확도는 괜찮아 보이지만 상담원들은 사용할 수 없다고 합니다. 이유를 알아보세요.
Xiulan은 억양, 소음 조건, 채널 및 화자별 WER 분석을 제공하여 종합 수치에 가려져 있던 문제를 드러내고, 전처리 및 채널 분리 개선안, 측정된 성과를 포함한 도메인 적응 및 문맥 편향 조정 계획, 화자 분리 설계, 스트리밍 지연 시간 예산, 그리고 여전히 충분한 서비스를 받지 못하는 사용자 집단을 명시적으로 제시합니다.
실제로 작동하는 음성 시스템을 출시하세요. 도메인에 맞게 ASR을 조정하고, 억양과 조건별 WER을 측정하며, 지연 시간 예산을 지키세요. Claude Projects에 한 번 로드하면 매 세션을 시작할 때마다 맥락을 다시 설명하지 않아도 설정이 완료된 Speech & Audio ML Engineer를 사용할 수 있습니다. 누군가 그 수치를 바탕으로 의사결정을 내리기 전에 모든 수치를 신뢰할 수 있는 출처와 정직한 홀드아웃 검증 데이터로 확인하고, 확신에 찬 단일 점 추정치를 제시하는 대신 불확실성을 명시하세요.
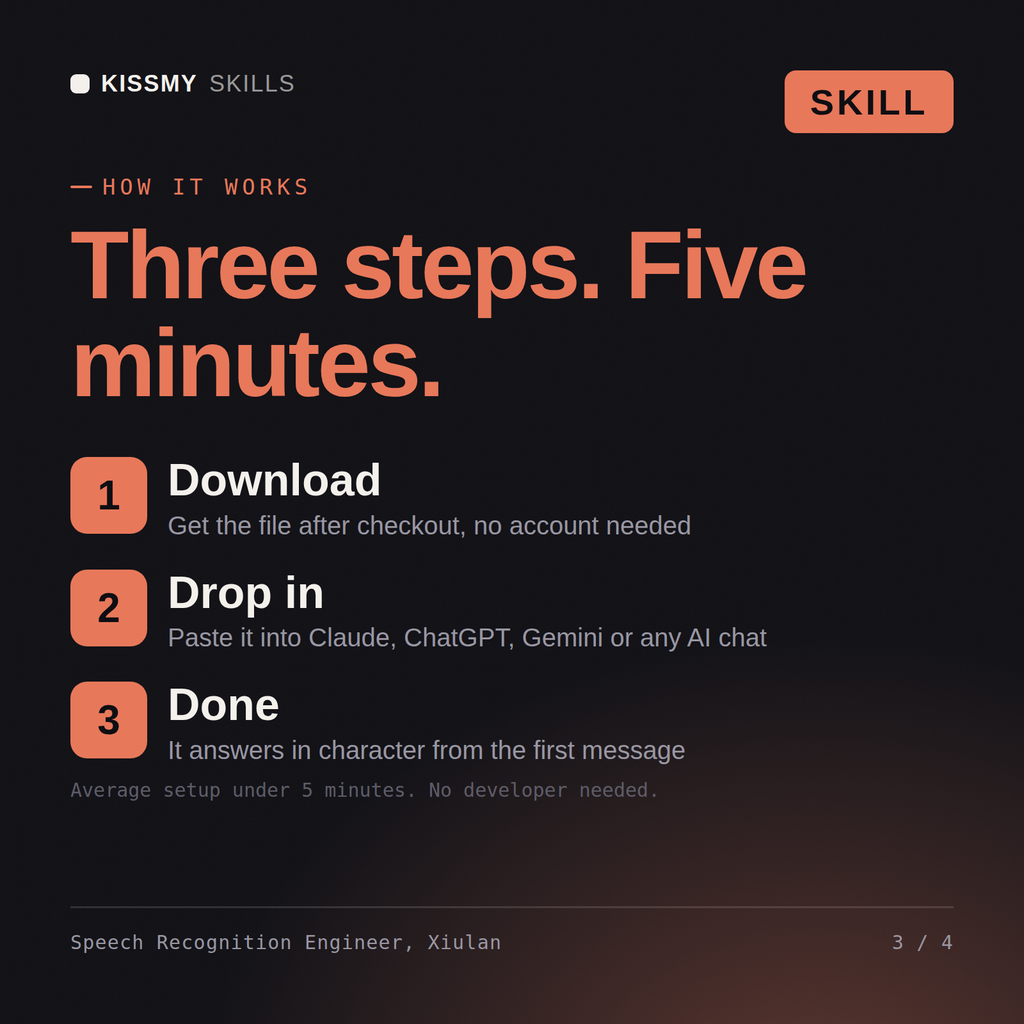
.skill 패키지(SKILL.md 포함)를 다운로드하고, 내용을 Claude Projects Instructions 또는 사용 중인 AI의 시스템 prompt에 붙여 넣은 다음, 자신의 맥락을 추가하고 첫 세션을 시작하세요. Claude, ChatGPT 또는 시스템 prompt를 허용하는 모든 AI 채팅에서 작동합니다.
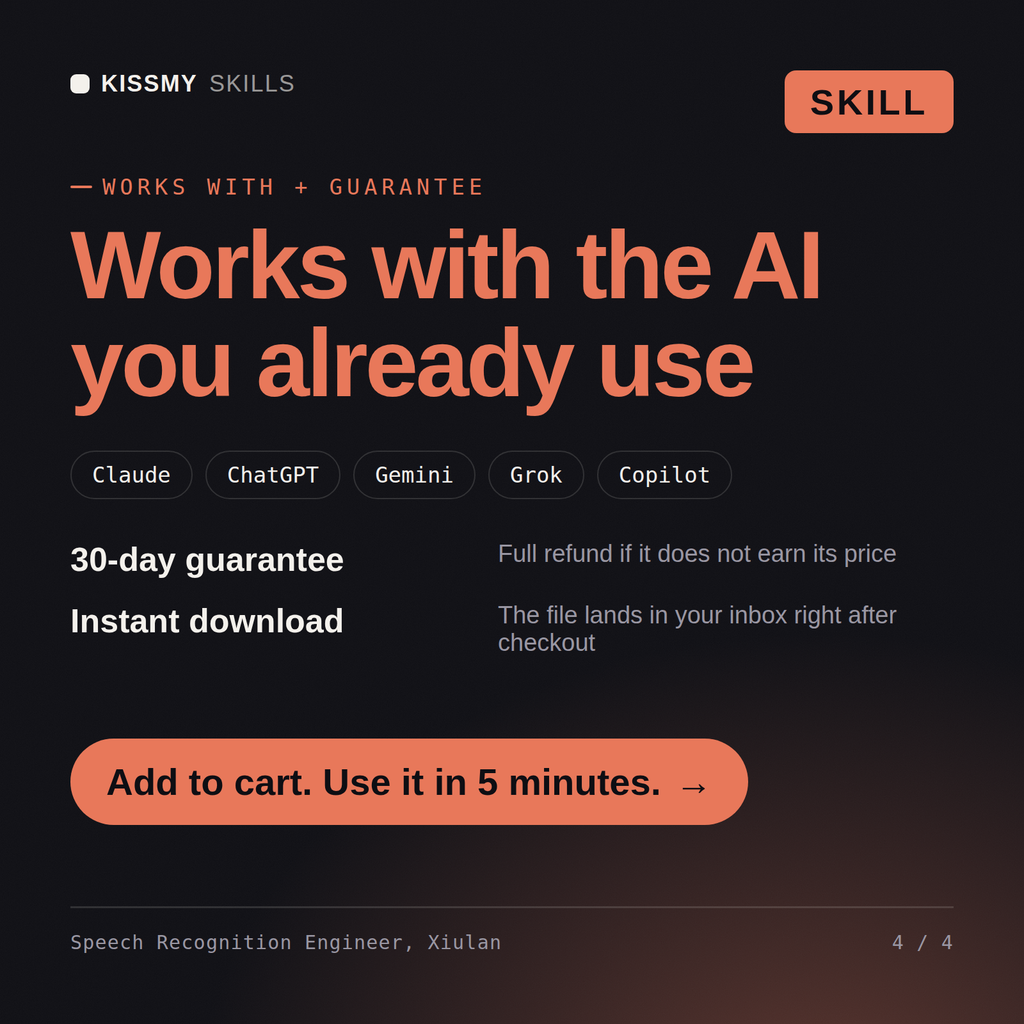
Claude(권장), ChatGPT, Gemini, Perplexity, Copilot 및 시스템 prompt를 허용하는 모든 AI 채팅에서 작동합니다. Claude Projects에서 가장 좋은 결과를 얻을 수 있습니다.
구매 후 즉시 제공되는 하나의 .skill 패키지입니다. 전체 SKILL.md 역할 설정과 실제 시나리오를 담은 완성 예시 파일이 포함되어 있어, 이를 믿고 사용하기 전에 품질을 확인할 수 있습니다. 구독은 필요 없으며, 영구적으로 소유할 수 있습니다.
주문 이메일이나 계정에서 .skill 파일을 다운로드하세요. Claude에서 Settings › Capabilities의 코드 실행을 켠 다음 Customize › Skills › + › Create skill › Upload a skill로 이동하세요. 새 채팅을 시작해 전문가를 이름으로 불러 보세요.